Pourquoi votre processeur passe sa vie à attendre ses données dans la mémoire vive (la RAM), et tout ce qu'on a inventé pour qu'il attende moins.
Pourquoi ce livre
Votre code PHP tourne sur une machine que vous ne voyez jamais. Vous écrivez une boucle, une requête, un foreach sur un tableau. Sous ce code, un processeur exécute des milliards d'instructions, de petits ordres comme « additionne ces deux nombres » ou « lis cette valeur ». La plupart du temps, il attend.
Pour le comprendre, imaginez un cuisinier très rapide. Ses ingrédients sont rangés loin de son plan de travail. Il passe plus de temps à les chercher qu'à cuisiner. Le processeur est ce cuisinier, et les ingrédients sont les données.
Jim Ledin, l'auteur du livre, part de ce constat. Son livre est gros : dix-neuf sections, du transistor (le plus petit interrupteur électronique) à l'informatique quantique. Je l'ai parcouru sur ExpertEdge, grâce à un partenariat avec Packt, l'éditeur. Le livre y est découpé en 198 leçons numérotées, dont j'ai lu 89 en détail.
Ledin illustre l'attente ainsi. Un processeur qui irait chercher chaque donnée dans la mémoire vive de l'ordinateur, la RAM, « passerait l'immense majorité de son temps à attendre ». Il remonte ensuite l'histoire des machines pour expliquer leur forme actuelle. Sa thèse : cette histoire éclaire « pourquoi les ordinateurs modernes sont construits comme ils le sont » (leçons 3 et 71).
Je suis développeur web, je n'ai pas le niveau pour juger ce livre en expert du matériel. J'en garde ce qu'un développeur web peut emporter : huit idées en trois familles.
- Idées 1 et 2 : la mémoire est lente. On la range donc en niveaux, du plus petit et rapide au plus grand et lent.
- Idées 3 à 6 : faire plusieurs calculs à la fois. Le processeur travaille comme une chaîne d'assemblage, et ses instructions doivent être faciles à découper. Une carte graphique pousse l'idée à l'extrême, et les modèles de langage en profitent.
- Idées 7 et 8 : chaque programme a un espace à lui, avec ses propres adresses. Il ne peut toucher ni aux autres programmes ni au système. Franchir cette frontière coûte du temps.
Les idées qui restent
1La mémoire est un escalier : plus la marche est grande, plus elle est lente
Première famille : la mémoire est lente. Reprenons le cuisinier de l'introduction. Il a trois endroits où prendre ses ingrédients, trois marches d'un escalier qui descend vers la réserve. Plus on descend, plus l'endroit est grand, et plus l'aller-retour est long. Un processeur moderne emploie plusieurs cuisiniers, que l'on appelle des cœurs.
La première marche est le plan de travail : les registres, quelques cases logées dans le processeur lui-même. Le processeur y range les valeurs avec lesquelles il calcule.
Tout en bas, la réserve est la mémoire principale, la DRAM : les barrettes de mémoire vive de la carte mère (dynamic random access memory). Chaque case y a un numéro, son adresse. Entre les deux, une étagère à portée de main sert d'intermédiaire, le cache, que nous voyons ensuite.
Le processeur et la DRAM n'ont pas progressé au même rythme. Le processeur est cadencé par une horloge, son métronome. Celles des processeurs Intel et AMD battent environ 1 000 fois plus vite que celle du premier PC d'IBM. La DRAM a beaucoup moins accéléré. Ledin chiffre l'écart en nanosecondes (ns, un milliardième de seconde), en prévenant qu'il simplifie. Lire une valeur dans un registre prend 1 ns, la lire dans la DRAM en prend 100 (leçon 71).
Le cache comble ce trou. C'est l'étagère du cuisinier : une petite mémoire très rapide, placée entre le processeur et la DRAM. Le matériel la remplit tout seul, sans une ligne de code du programmeur. Elle garde ce qu'on vient d'utiliser. Dans l'exemple, elle répond en 4 ns. La première lecture d'une adresse paie les 100 ns. Les suivantes, sur la même adresse ou ses voisines, ne coûtent plus que 4 ns. Ledin résume : le cache est « 4 fois plus lent que les registres, mais 25 fois plus rapide que la DRAM » (leçon 71).
Le cache marche parce que les programmes se répètent. Ils relisent les mêmes données et touchent leurs voisines. Le cache ne charge donc jamais un octet seul (8 bits) : il charge une ligne de cache, un bloc de 64 octets. Résultat : le processeur trouve sa donnée dans le cache pour 95 à 97 % des accès (leçons 70 et 72).
Comptons ce que cela donne, avec 96 % de succès, le milieu de la fourchette. Un accès coûte en moyenne 0,96 × 4 ns + 0,04 × 100 ns = 7,84 ns. C'est environ 8 ns au lieu de 100.
Les vrais processeurs empilent plusieurs caches, appelés niveaux. Le niveau 1 (L1) est le plus petit et le plus proche du processeur. Chaque niveau suivant est plus grand et plus lent que le précédent. Prenons un Core Ultra 9 de 2024. Le livre y cite 48 Ko de niveau 1 pour les données de chaque cœur de performance. Il cite aussi 32 Mo de niveau 3 partagés (leçons 74 et 128).
Cet escalier ne s'arrête pas au processeur. Ledin applique les mêmes compromis « d'un seul processeur aux systèmes distribués mondiaux ». Ils portent sur le temps de réponse, le débit (le travail fait par seconde) et le coût. Son exemple est un moteur de recherche. Un serveur d'index garde la liste des pages à renvoyer, et il en tient une partie en mémoire vive.
Si la réponse manque, ce serveur cherche sur son disque. Puis il interroge les autres serveurs de la même armoire (un rack), les autres armoires du même groupe (un cluster), enfin d'autres groupes. Chaque étage est plus lent que le précédent (leçon 131).
Exemple pratique, pas du livre : un cache en mémoire devant votre base de données est une marche de plus.
Que doit faire le développeur ? Rien pour en profiter, dit le livre. Il gagne à dimensionner ses structures pour tenir dans les caches. Puis il mesure : « la façon la plus efficace de choisir entre plusieurs algorithmes viables est de les mesurer chacun avec soin » (leçon 74).
Un exemple de mon cru, pas du livre. En Go, un tableau [1024][1024]int64 contient 1 024 rangées de 1 024 nombres de 8 octets. Cela fait 8 Mo d'un seul bloc, rangés rangée après rangée. On peut l'additionner de deux façons :
var m [1024][1024]int64 // 1024 × 1024 × 8 octets = 8 Mo, rangée après rangée
var total int64

// ✓ rangée par rangée : on avance de 8 octets, chaque ligne de cache sert 8 fois
for i := 0; i < 1024; i++ {
    for j := 0; j < 1024; j++ { total += m[i][j] }
}

// ✗ colonne par colonne : on saute de 8 Ko, chaque lecture charge une ligne de cache neuve
for j := 0; j < 1024; j++ {
    for i := 0; i < 1024; i++ { total += m[i][j] }
}
Les deux boucles calculent la même somme. Dans la première, une ligne de cache de 64 octets apporte 8 nombres utiles, car 64 ÷ 8 = 8. Dans la seconde, elle n'en apporte qu'un. Elle risque en plus d'être évincée, c'est-à-dire remplacée par une autre ligne, avant de resservir.
Je l'ai mesuré sur un portable récent (processeur AMD, 32 Mo de cache L3, Go 1.26), avec deux largeurs de rangée.
| Largeur d'une rangée | Rangée par rangée | Colonne par colonne | Écart |
|---|---|---|---|
| 1 024 nombres (saut de 8 192 octets) | 0,44 ms | 3,2 ms | 7 fois |
| 1 025 nombres (saut de 8 200 octets) | 0,38 ms | 0,86 ms | 2,3 fois |
Les 8 Mo sont encore plus petits que le cache L3, donc sur un tableau plus gros l'écart serait plus grand. La largeur compte : un saut d'exactement 8 192 octets, une puissance de 2, envoie beaucoup de lectures vers les mêmes emplacements du cache, qui se chassent entre eux. Avec 1 025 nombres par rangée, cet effet s'estompe. Le livre ne fait pas l'expérience, et ces chiffres sont ceux de ma machine : mesurez la vôtre, comme il le conseille.
2Le cache range chaque adresse dans une place fixe, et deux adresses peuvent s'y battre
L'escalier dit combien on gagne. Reste à savoir comment le cache retrouve une donnée parmi des milliards d'adresses. Une adresse s'écrit en bits, des 0 et des 1. Dans l'exemple, elle a 32 bits et peut prendre environ 4 milliards de valeurs.
Le livre prend un cache d'instructions de 512 octets, avec des lignes de 64 octets. Un cache d'instructions garde le code du programme, à côté du cache qui garde ses données. Ici, le programme est une boucle : ses instructions sont relues à chaque tour.
Le cache a donc 512 ÷ 64 = 8 places pour des lignes. Le livre appelle chaque place un ensemble. Pour l'instant, un ensemble contient une seule ligne. Le cache découpe chaque adresse en trois morceaux (leçon 72) :
- la position : les 6 bits de droite, qui désignent un octet parmi les 64 de la ligne (64 = 2⁶).
- le numéro d'ensemble : les 3 bits suivants, qui désignent un des 8 ensembles (8 = 2³).
- l'étiquette (tag) : les 23 bits restants, qui disent quel morceau de mémoire occupe l'ensemble (32 − 6 − 3 = 23).
Pour lire, le cache prend le numéro d'ensemble et va droit à cet ensemble. Il compare l'étiquette rangée là avec celle de l'adresse. Égales : c'est un succès, la donnée est là. Différentes : c'est un échec. Le cache recharge alors la ligne depuis la DRAM, et elle écrase l'ancienne.
Le livre déroule deux boucles. Le code de la première occupe 256 octets, à partir de l'adresse 0x8000. Le préfixe 0x signale l'hexadécimal, la base 16, comme en PHP. Le livre écrit cette adresse 8000h. Au premier tour, les 4 lignes du code (256 ÷ 64) remplissent 4 ensembles. Aux tours suivants, tout est dans le cache : 100 % de succès.
Le code de la seconde occupe 1 024 octets, deux fois le cache. Cela fait 1 024 ÷ 64 = 16 lignes pour 8 ensembles. À mi-parcours, l'adresse vaut 0x8000 + 512. Or 512 s'écrit 0x200 en hexadécimal (2 × 16 × 16). L'adresse vaut donc 0x8200.
Écrivons les deux adresses en binaire sur 16 bits. Chaque chiffre hexadécimal vaut 4 bits : 8 = 1000, 2 = 0010, 0 = 0000. Les 16 bits de gauche d'une adresse de 32 bits valent 0 ici, et le livre les ignore aussi. Le découpage ci-dessous est refait par moi, pas copié du livre :
0x8000 = 1000 0000 0000 0000
0x8200 = 1000 0010 0000 0000

          étiquette | n° d'ensemble | position
0x8000  =  1000000  |      000      |  000000
0x8200  =  1000001  |      000      |  000000   ← même ensemble, étiquette différente
Les deux adresses ne diffèrent que par un bit de l'étiquette. Elles ont le même numéro d'ensemble, 000, donc elles visent le même ensemble. La seconde évince la première.
Suivons la boucle. Dans la première moitié du code, les 8 lignes occupent les 8 ensembles. Dans la seconde moitié, les 8 autres lignes visent les mêmes ensembles et les évincent toutes : 0x8240 évince 0x8040, et ainsi de suite. Au tour suivant, la boucle repart de 0x8000 et doit tout recharger. Chaque tour recharge donc tout.
Le cache aide encore, car une ligne chargée sert à toutes les instructions qu'elle contient. Chaque échec coûte pourtant environ 25 fois un succès (leçon 72).
La parade aux collisions s'appelle le cache associatif à deux voies. Les mêmes 512 octets sont coupés en deux moitiés égales, les voies, de 4 ensembles chacune et consultées en même temps. Le numéro d'ensemble tient alors sur 2 bits, et l'étiquette sur 24 (32 − 6 − 2).
Chaque ensemble accueille maintenant deux lignes, une par voie. Le cache compare l'étiquette de l'adresse à celles des deux lignes en même temps, d'où le mot « associatif ». Les processeurs modernes ont souvent 4, 8 ou 16 voies. Selon le livre, ces caches obtiennent en pratique plus de succès (leçon 73).
Cette parade ne sauve pas la seconde boucle, et c'est mon calcul : ses 16 lignes ne rentrent toujours pas dans 8 places. Elle évite que deux adresses s'évincent alors que le reste du cache est libre.
3Le processeur travaille à la chaîne, et une instruction qui attend l'autre fait un trou dans la chaîne
Deuxième famille : faire plusieurs calculs à la fois. Les caches font venir les données à temps. Reste à occuper le processeur. Une instruction passe par quatre étapes : aller la chercher, la décoder (lire ce qu'elle demande), l'exécuter, écrire le résultat. Chaque étape a son propre circuit.
Chaque étape dure un cycle d'horloge, un battement du métronome du processeur. Un GHz vaut un milliard de cycles par seconde. À 3 GHz, un cycle dure donc un tiers de nanoseconde. Sans astuce, l'instruction suivante attend la fin de la précédente. Une instruction prend alors quatre cycles.
Le livre mesure le débit en IPC, les instructions terminées par cycle (instructions per clock). Ici, l'IPC vaut 0,25 : une instruction pour quatre cycles (leçon 75).
Pendant ce temps, un seul des quatre circuits travaille, et les trois autres attendent. Le pipeline les réveille. C'est une chaîne d'assemblage : chaque étape passe à l'instruction suivante dès qu'elle a fini, comme un poste d'usine qui passe sa pièce. Quatre instructions avancent alors en même temps, chacune à une étape différente.
L'IPC monte à 1, quatre fois mieux. Un processeur qui a plusieurs chaînes côte à côte, dit superscalaire, lance deux instructions par cycle et atteint 2. Un processeur de bureau haut de gamme tourne « autour de 2 à 4 » (leçons 75 et 78).
La chaîne se grippe dès qu'une instruction attend le résultat d'une autre. L'exemple est en assembleur, le langage du processeur, pour les puces d'Intel et d'AMD (eax, ebx, ecx, edx sont des registres) :
inc eax        ; eax = eax + 1
add ebx, eax   ; a besoin du nouvel eax : attend la ligne du dessus
mov ecx, edx   ; ne dépend de rien
Le livre appelle ce blocage un aléa (pipeline hazard). L'instruction add a besoin du nouvel eax, que inc n'a pas fini d'écrire. Voici le calendrier dans une chaîne à quatre étapes, simplifié et de ma main (C chercher, D décoder, X exécuter, É écrire) :
cycle          1  2  3  4  5  6
inc eax        C  D  X  É
add ebx, eax      C  D  -  X  É     ← le « - » est la bulle
Sans parade, add doit attendre, son poste reste vide, et ce trou avance dans la chaîne : une bulle. Une première parade est le raccourci : le résultat de inc passe directement à add, sans attendre que inc l'écrive dans le registre. Dans ce calendrier, add s'exécute alors au cycle 4, sans bulle.
La seconde parade est d'exécuter mov avant add. Le résultat est identique, et mov occupe la place où la bulle serait apparue. inc a le temps d'écrire eax (leçon 76). Le processeur remet les instructions dans cet ordre tout seul, pendant l'exécution.
Les if posent le même problème en pire. Un if compilé devient un branchement conditionnel : un saut qui dépend d'une condition. Or cette condition n'est pas encore calculée quand la chaîne doit déjà charger la suite.
Le processeur parie donc sur le chemin : c'est la prédiction de branchement. Pari gagné, rien n'attend. Pari perdu, il vide la chaîne des instructions chargées par erreur et recommence. Le conseil du livre aux développeurs : « quand c'est possible, évitez carrément les branchements » dans les boucles internes (leçon 77).
Le livre expose ce pari en un court paragraphe. Il décrit ensuite les prédicteurs d'un Core Ultra 9 de 2024, sans aucun taux de réussite (leçon 128).
4x86, ARM, RISC-V : trois jeux d'instructions, et celles de taille fixe se découpent plus vite
Remplir la chaîne suppose de charger et de lire vite les instructions, rangées les unes derrière les autres en mémoire. Leur forme dépend du jeu d'instructions du processeur : la liste des ordres qu'il comprend, et leur format en octets. On l'abrège ISA (instruction set architecture).
Le livre compare trois jeux d'instructions. Le x86 équipe les PC et les serveurs d'Intel et d'AMD. Son nom vient de la série qui a commencé avec la puce Intel 8086 de 1978, suivie des 80186, 80286, 80386 et 80486. L'ARM équipe les téléphones, les montres et les tablettes. Le RISC-V est une spécification libre, développée à l'université de Berkeley et annoncée en 2011. RISC veut dire reduced instruction set computer : peu d'instructions, toutes simples (leçons 97 et 111).
Les instructions du x86 font de 1 à 15 octets. Imaginons, pour l'exemple (de ma main, pas du livre), trois instructions collées en mémoire, de 1, 3 et 2 octets. Le décodeur est le circuit qui lit ce que demande chaque instruction. Il ne sait pas où la deuxième commence avant d'avoir lu le début de la première. Il avance donc d'une instruction à la fois.
Ledin le dit sans détour : la longueur variable « rend le décodage des instructions assez complexe » (leçon 101). Pour la chaîne, la conséquence est mon raisonnement, pas celui du livre : le décodeur fournit moins vite des instructions prêtes à exécuter.
La longueur variable gêne aussi les outils de débogage. Pour afficher le code qui précède un point d'arrêt, ils doivent le lire à rebours. Or la fin d'une longue instruction peut former une instruction valide (leçon 101).
ARM et RISC-V font le choix inverse. Leurs instructions standard font 32 bits, soit 4 octets. Le décodeur coupe donc tous les 4 octets, sans rien lire. RISC-V a aussi une extension, un module facultatif, qui ajoute des versions de 2 octets (leçons 103 et 115).
D'après le livre, ces jeux simples ont été conçus pour le pipeline. Le x86, lui, doit rester compatible avec ses anciennes instructions, créées avant le pipeline. Il consacre donc une grande part de sa puce à des circuits qui les font marcher vite (leçon 76).
Il découpe aussi en interne chaque instruction en micro-opérations, de petits morceaux plus simples : 1 à 3 pour les instructions les plus simples (leçon 77).
RISC-V pousse cette simplicité au bout : 47 instructions de base (leçon 112). Il n'a pas de registre de drapeaux. Ce sont des bits que d'autres processeurs posent après un calcul, pour dire « résultat nul » ou « retenue ». RISC-V range plutôt le résultat d'une comparaison, 0 ou 1, dans un registre ordinaire.
Pour savoir si une addition a produit une retenue, le programme compare donc la somme à l'un des nombres additionnés. Si la somme est plus petite que ce nombre, il y a eu une retenue (leçon 111).
Un exemple de ma main, sur 8 bits, où un registre ne dépasse pas 255 :
200 + 100 = 300  → le registre garde 300 − 256 = 44   (44 < 200 : retenue)
 50 + 100 = 150  → le registre garde 150              (150 ≥ 50 : pas de retenue)
Quel jeu d'instructions est le meilleur, x86 ou ARM ? Ledin refuse de trancher : « chacune est peut-être meilleure dans certaines circonstances » (leçon 109).
5Une carte graphique n'est pas un processeur plus rapide : ce sont 10 752 petits calculateurs qui font la même chose
Le pipeline fait travailler plusieurs étapes à la fois dans un seul cœur. Le GPU est la puce de la carte graphique (graphics processing unit). Il pousse cette idée de faire beaucoup de choses en même temps à l'extrême. Son travail d'origine est l'image : des millions de pixels, chacun calculé sans attendre les autres.
L'exemple est la puce GA102 de la carte RTX 3090, sortie en 2020. La puce s'emboîte comme des poupées russes : 7 grappes, qui contiennent chacune 12 multiprocesseurs. Chaque multiprocesseur contient 4 processeurs de warp, et chacun regroupe 32 cœurs. Seul le produit compte : 7 × 12 × 4 × 32 = 10 752 cœurs, que NVIDIA appelle cœurs CUDA.
| Niveau | Combien dans le niveau du dessus | Total cumulé |
|---|---|---|
| Grappes | 7 sur la puce | 7 |
| Multiprocesseurs | 12 par grappe | 84 |
| Processeurs de warp | 4 par multiprocesseur | 336 |
| Cœurs | 32 par processeur de warp | 10 752 |
En face, un processeur de bureau haut de gamme a « au plus quelques dizaines de cœurs ». La RTX 3090 vendue n'en active que 10 496. Deux multiprocesseurs de 128 cœurs sont tombés en panne à la fabrication, et on les a éteints. Vendre ces puces imparfaites, explique le livre, améliore le rendement de fabrication : on jette moins de puces (leçon 92).
Chaque cœur est simple : à chaque cycle, il fait une multiplication et une addition, A × B + C. Cela compte pour 2 opérations. L'horloge de la RTX 3090 bat à 1,7 GHz, soit 1,7 milliard de cycles par seconde. Calculons : 10 496 cœurs × 1,7 milliard × 2 opérations font environ 35,7 billions (milliers de milliards) d'opérations par seconde. Le livre écrit 35,6 billions (leçon 93).
Le prix de cette puissance est une contrainte. Les cœurs travaillent par warp, un groupe de 32 threads. Un thread est une suite d'instructions qu'un cœur déroule. Les 32 cœurs d'un processeur de warp exécutent la même instruction au même moment, chacun sur ses propres données. Le mot vient du métier à tisser Jacquard. Ses fils de chaîne, les warp threads, se lèvent ou se baissent tous ensemble (leçons 92 et 93).
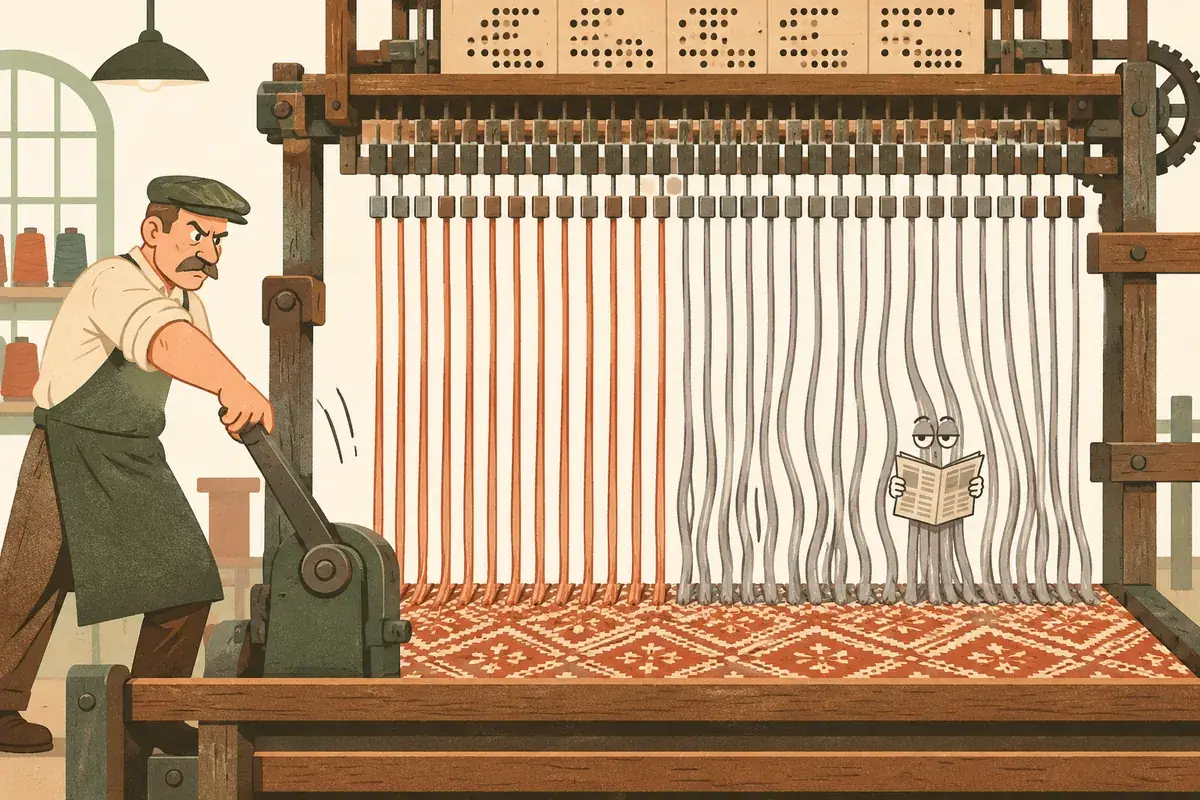
Que se passe-t-il quand un if dépend des données ? Certains threads veulent la branche, d'autres non. Le GPU doit alors « exécuter deux fois les chemins divergents ». Au premier passage, les threads du if travaillent et les autres sont mis en pause par le matériel. Au second, c'est l'inverse.
Le conseil du pipeline revient ici en plus fort : évitez les branchements. Le warp donne son meilleur débit quand tous ses threads suivent le même chemin (leçon 93).
Le livre pose donc une limite. Un GPU n'est « vraiment efficace que pour accélérer des algorithmes qui exploitent le parallélisme de données » (leçon 90). Autrement dit, la même opération sur un grand tableau.
Mon extrapolation, pas celle du livre : une logique métier pleine de conditions y gagne peu. Chaque condition qui divise un warp impose en effet deux passages. Un if ne coûte pourtant que s'il sépare les threads d'un même warp : si les 32 prennent la même branche, il est gratuit. Le vrai manque, dans une application web, est ailleurs : peu de données indépendantes à traiter en même temps, et beaucoup d'attente.
6Un modèle de langage comme ChatGPT, vu du processeur, c'est une montagne de multiplications
Le GPU sait multiplier vite et en parallèle. C'est exactement ce que réclament les modèles de langage. Un modèle de langage est le moteur de ChatGPT ou de Claude (LLM, large language model). Il « tente d'analyser et de produire du texte en prédisant le mot suivant ». Ledin le compare à l'autocomplétion d'un téléphone (leçon 134).
Le texte est d'abord découpé en tokens, des morceaux de mots. « Tell me about GPT-2. » donne ainsi 8 tokens : « Tell », « me », « about », « G », « PT », « - », « 2 » et « . ». La raison du découpage de « GPT » : ce mot était rare dans les textes d'entraînement (leçon 138).
Le modèle produit sa réponse token après token. À chaque token, il repasse tout le texte déjà écrit, question et début de réponse, dans ses couches de calcul. Il en tire le token suivant et l'ajoute au texte. Le livre appelle chaque tour une itération. Le contexte est le texte que le modèle regarde, ici 1 024 tokens au plus (leçon 135).
L'exemple est GPT-2 small, un modèle de 2019 à 124 millions de paramètres, les nombres appris pendant l'entraînement. Chaque token y devient une liste de 768 nombres, tirée d'une table apprise elle aussi. Un texte de 1 024 tokens forme donc une matrice, un tableau de 1 024 lignes sur 768 colonnes (leçons 135 et 138).
Le modèle empile 12 couches, des étages de calcul traversés l'un après l'autre. Chaque couche a deux blocs principaux. Le premier est l'attention. Pour chaque token, elle calcule quels tokens précédents comptent pour comprendre le sien. Le second est le bloc dense, que le livre appelle MLP (multi-layer perceptron) : un réseau où chaque nombre d'entrée est relié à chaque neurone. Il traite ensuite chaque token séparément (leçon 137).
Comptons avec le livre, sur une itération au maximum de contexte, soit 1 024 tokens. L'attention a besoin de trois matrices : Q, K et V (requête, clé et valeur en anglais). Chacune s'obtient en multipliant la matrice du texte par un tableau de 768 sur 768, rempli pendant l'entraînement (leçons 136 et 140).
Pourquoi 768 sur 768 ? Parce qu'une matrice de 1 024 × 768 multipliée par un tableau de 768 × 768 donne une matrice de 1 024 × 768. Chaque token garde ses 768 nombres, mais transformés.
Q contient 1 024 × 768 = 786 432 nombres. Chacun demande 768 multiplications : on multiplie une ligne de 768 nombres par une colonne de 768 nombres, puis on additionne. Pour Q seule, cela fait 786 432 × 768 = 603 979 776 multiplications, soit environ 604 millions.
K et V ont la même taille, et ce calcul se refait dans chacune des 12 couches. Cela fait 3 × 12 = 36 multiplications de matrices, soit 36 × 604 millions, plus de 21 milliards de multiplications. Chacune s'accompagne d'une addition : le livre parle de MAC (multiply-accumulate), une multiplication suivie d'une addition (leçon 140).
Le bloc dense de chaque couche fait deux multiplications. Il multiplie le texte par un tableau de 768 sur 3 072, puis le résultat par un tableau de 3 072 sur 768. Chaque multiplication coûte 1 024 × 3 072 × 768, soit environ 2,4 milliards. Cela fait 4,8 milliards par couche, et 12 × 4,8 = environ 58 milliards pour les 12 couches (leçons 137 et 140).
Ces 58 milliards s'ajoutent aux 21 milliards de Q, K et V. S'y ajoute la multiplication qui termine l'attention, de même taille que Q. Le livre la cite sans la chiffrer, et mon calcul donne environ 7 milliards (12 × 604 millions). Le livre classe ces multiplications parmi celles qui pèsent 80 à 95 % des calculs sur nombres à virgule du modèle. Ce pourcentage vient du livre, je ne l'ai pas recalculé (leçon 140).
| Bloc | Multiplications de matrices | Coût de chacune | Total |
|---|---|---|---|
| Q, K et V | 36 (3 × 12 couches) | 604 millions | ≈ 21,7 milliards |
| Fin de l'attention | 12 (une par couche) | 604 millions | ≈ 7,2 milliards |
| Bloc dense (MLP) | 24 (2 × 12 couches) | 2,4 milliards | ≈ 58 milliards |
| Somme | ≈ 87 milliards |
Cette somme de 87 milliards est mon addition, pas celle du livre. Elle montre que le bloc dense pèse environ les deux tiers du total (58 sur 87), plus que l'attention.
Or chaque nombre du résultat se calcule sans attendre les autres : c'est le parallélisme de données vu avec le GPU. Voilà pourquoi les modèles tournent sur des GPU.
Reste un gaspillage possible. Ce décompte refait tout le texte à chaque token, sans mémoire. Les anciens tokens ne changent pas d'un token à l'autre, mais leurs K et V seraient recalculés. Le cache KV les garde : cela « réduit fortement le travail par token, mais pèse sur les besoins en mémoire ».
C'est le même geste que le cache du processeur : garder un résultat plutôt que le refaire, au prix de la place qu'il occupe. Le livre ne consacre qu'un court paragraphe au cache KV, et n'explique pas pourquoi seuls K et V sont gardés (leçon 140).
Le livre ne donne pas de coût par token. Il chiffre en revanche l'énergie : une armoire de serveurs d'IA peut consommer 50 à 100 kilowatts (leçon 142).
Voici mon extrapolation, pas celle du livre. Le calcul ci-dessus, sans cache, ne concerne que le petit GPT-2. Les modèles récents, dont Claude, sont beaucoup plus gros que GPT-2, dit le livre (leçon 135). Chaque token qu'ils produisent représente donc bien plus de calcul. Et comme le cache KV garde les calculs au prix de la mémoire, un long contexte se paie en calcul ou en mémoire.
7Chaque adresse de votre programme est une fiction, traduite à la volée
Troisième famille : chaque programme a un espace à lui. Le premier outil s'appelle la mémoire virtuelle. Reprenons l'adresse, le numéro d'une case de mémoire : avec ce nouvel outil, elle devient une fiction.
Le problème vient des vieilles machines. Sur un PC sous MS-DOS, un ancien système d'exploitation, l'adresse écrite dans le programme était celle de la puce de mémoire. Deux programmes devaient donc se partager les adresses à la main. Les programmes qui restaient chargés en mémoire derrière les autres s'y essayaient, et ils se sont fait « une réputation d'instabilité » (leçon 65).
La mémoire virtuelle donne à chaque programme son propre espace d'adresses, numéroté à partir de zéro pour lui seul. L'adresse écrite dans le programme est virtuelle. Chaque programme croit être seul dans la machine. Un circuit du processeur, la MMU (memory management unit), traduit l'adresse virtuelle en adresse réelle, celle de la barrette.
La MMU travaille par pages, des blocs de 4 Ko ou plus. Les pages peu utilisées peuvent partir sur le disque, dans un fichier d'échange (leçon 65).
L'exemple est Windows NT en 32 bits. Une page de 4 Ko contient 4 096 octets, soit 2¹² : les 12 bits du bas d'une adresse donnent la position dans la page. Les 20 bits du haut servent à retrouver la page. Ils se coupent en deux tranches de 10 bits (leçon 66).
Une table de pages est une liste de 1 024 entrées de 4 octets. Chaque entrée traduit une page, donc une table couvre 1 024 × 4 Ko = 4 Mo. Pour couvrir les 4 Go d'adresses d'un programme, il faut 1 024 tables. Le répertoire de pages est la liste de ces 1 024 tables. Le système d'exploitation remplit ces tables (leçon 66).
| Niveau | Entrées | Ce que couvre une entrée | Ce que couvre le niveau |
|---|---|---|---|
| Répertoire de pages | 1 024 | 4 Mo (une table) | 4 Go |
| Table de pages | 1 024 | 4 Ko (une page) | 4 Mo |
| Page | 4 096 octets | 1 octet | 4 Ko |
Le livre suit l'adresse 0x00402003. Voici le même découpage en PHP (mon code, pas celui du livre) :
$v = 0x00402003;
echo $v >> 22, "\n";       // A : numéro dans le répertoire de pages (les 10 bits du haut : 32 − 22 = 10)
echo ($v >> 12) & 0x3FF, "\n"; // B : numéro dans la table de pages (0x3FF = dix bits à 1)
echo $v & 0xFFF, "\n";     // C : position dans la page (0xFFF = douze bits à 1)
L'adresse vaut en binaire 0000 0000 0100 0000 0010 0000 0000 0011. Les 10 premiers bits (0000000001) valent 1, les 10 suivants (0000000010) valent 2, les 12 derniers (000000000011) valent 3. Le programme affiche donc 1, 2 et 3 : A = 1, B = 2 et C = 3.
La traduction suit ces trois valeurs. Un registre du processeur, CR3, donne l'adresse du répertoire de pages du programme en cours. L'entrée A = 1 du répertoire désigne une table de pages. L'entrée B = 2 de cette table donne l'adresse réelle de la page. La position C = 3 désigne l'octet voulu (leçon 66).
Faire ce parcours à chaque lecture serait ruineux. Il demande au moins trois lectures de la DRAM : le répertoire, la table, puis la donnée elle-même. Avec les 100 ns de l'idée 1, cela fait 300 ns au lieu de 100 (calcul de ma main).
Le processeur garde donc les traductions récentes dans le TLB, un cache de traductions (translation lookaside buffer). Le TLB a souvent 64 entrées ou moins, et une recherche réussie prend en général un cycle (leçon 68).
Quand le TLB n'a pas la traduction, le livre parle de défaut de page (page fault). Le mot « défaut » ne veut pas dire erreur. C'est une exception : le processeur suspend le programme et appelle le système, qui règle le cas puis rend la main (leçons 66 et 80).
Le livre distingue deux cas. Dans le défaut léger, la page est en mémoire et seule la traduction manque. Dans le défaut dur, la page est partie sur le disque. Il faut alors lire le disque. Ce défaut dur est « des milliers à des millions de fois plus lent » que le défaut léger (leçon 66).
- Sur x86, le matériel parcourt seul les tables quand la page est en mémoire. Il n'appelle pas le système dans ce cas : le défaut de page n'arrive que si la page manque. Le livre applique pourtant le mot « défaut de page » au premier cas. Source : Wikipedia, article « Translation lookaside buffer ».
- Deux niveaux de tables évitent un seul tableau géant par programme. Un tableau unique de 2²⁰ entrées de 4 octets pèserait 4 Mo par programme (mon calcul). Avec deux niveaux, le système crée seulement les tables des zones utilisées. Source : Wikipedia, article « Page table ».
Ce que vous y gagnez tous les jours, c'est l'isolation. Chaque programme n'a que ses propres adresses, et aucune ne mène à la mémoire d'un autre. Une adresse sans page attribuée déclenche une violation d'accès (leçon 65).
Un pointeur, en C, est une variable qui contient une adresse. Un pointeur nul vise l'adresse 0. Cette adresse est hors de la plage valide du programme, même si son espace est numéroté à partir de zéro. La MMU lève alors une exception, et le programme plante avec un message. Sans MMU, il aurait lu n'importe quoi en silence (leçon 68).
8Demander un service au système coûte cher, et une machine virtuelle ajoute un étage
La mémoire virtuelle isole les programmes entre eux. Reste à les isoler du système lui-même. Le noyau est la partie centrale du système d'exploitation, seule autorisée à parler au matériel. Ledin le compare à un château à enceintes successives. Chaque enceinte est un anneau de privilège, un niveau d'autorisation. Le x86 en prévoit quatre, mais Windows et Linux n'en utilisent que deux.
L'anneau 0, au centre, abrite le noyau et les pilotes, les programmes qui commandent les périphériques. L'anneau 3, à l'extérieur, s'appelle aussi le mode utilisateur et abrite les applications. Le processeur ne laisse entrer une application que par une porte contrôlée (leçons 81 et 82).
En anneau 3, une application ne peut ni réserver de mémoire, ni ouvrir un fichier, ni écrire à l'écran. Elle doit le demander au noyau par un appel système (leçon 82). Exemple pratique, pas du livre : en PHP, fopen() ou file_get_contents() finissent par une telle demande.
La porte est une instruction du processeur. Elle contrôle la demande, fait passer de l'anneau 3 à l'anneau 0, puis rend la main. Sous Windows, avant XP, int 2eh mettait « plus de 1 000 cycles d'horloge » pour atteindre le noyau. À 3 GHz, c'est plus de 330 ns, plus de trois fois un accès à la DRAM.
En 1997, Intel a ajouté sysenter, environ trois fois plus rapide, soit autour de 330 cycles. Le livre ne dit pas pourquoi le passage coûte autant. Il note qu'un système occupé peut faire des milliers de demandes par seconde (leçon 82).
| Opération | Cycles d'horloge | À 3 GHz |
|---|---|---|
| Un accès à la DRAM | environ 300 | environ 100 ns |
Appel système avec sysenter | environ 330 | environ 110 ns |
Appel système avec int 2eh | plus de 1 000 | plus de 330 ns |
Le calcul est de ma main : à 3 GHz, 3 cycles font 1 ns. Le passage par sysenter coûte donc à peu près un accès à la mémoire.
- Depuis la découverte de Meltdown, le noyau Linux sépare les tables de pages du noyau et celles des programmes (KPTI). Chaque appel système en change, ce qui le rend plus cher. Source : documentation du noyau Linux, docs.kernel.org/arch/x86/pti.html.
La frontière entre les anneaux se retrouve un étage plus haut, avec la machine virtuelle (VM). C'est un ordinateur simulé, comme un serveur loué chez un hébergeur. Le système d'exploitation de la VM, dit invité, est écrit pour une vraie machine. Il croit donc tourner en anneau 0 (leçon 121).
L'invité n'y est pas. L'hyperviseur, le logiciel qui fait tourner les VM, le lance en mode utilisateur. Il tourne soit directement sur la machine, soit comme une application d'un autre système (leçons 121 et 122).
Une instruction privilégiée est un ordre réservé à l'anneau 0, comme modifier un réglage interne du processeur. Quand l'invité en exécute une, le processeur déclenche une exception. L'hyperviseur l'intercepte et simule l'opération (leçon 121).
Cette interception ne marche que si toute instruction dangereuse déclenche une exception. Une instruction est dangereuse si elle lit ou modifie l'état réservé de la machine. Or, sur les centaines d'instructions du Pentium, « 17 étaient dangereuses sans déclencher d'exception » (leçon 122).
L'une d'elles, sidt, lit un registre système sans alerte. L'invité reçoit alors les valeurs de la machine réelle, l'hôte, et non celles de sa machine simulée. L'hyperviseur n'est même pas prévenu. Il a donc dû réécrire ces instructions : avant d'exécuter le code de l'invité, il les remplace par des suites équivalentes (leçon 122).
Pour éviter cette réécriture, Intel et AMD ont ajouté une aide matérielle en 2005 et 2006. Aveu du livre : la performance des VM « ne s'est pas nettement améliorée ». Le frein venait des tables de pages, qui traduisent les adresses comme pour la mémoire virtuelle de l'idée 7 (leçon 122).
L'invité croit régler lui-même les tables qui traduisent ses adresses. Il n'en a pas le droit. L'hyperviseur garde donc une copie à lui, les tables de pages fantômes (shadow page tables), et intercepte chaque accès de l'invité (leçon 121).
Une machine virtuelle impose donc deux traductions, même si le livre ne l'énonce pas ainsi. L'adresse virtuelle de l'invité devient une adresse de sa machine simulée, puis une adresse de la vraie mémoire. Une autre aide matérielle, la table de pages étendue (EPT), a en grande partie supprimé les copies (leçon 121).
Mon avis, honnêtement
Ce livre répond-il à la question « pourquoi la machine est-elle construite ainsi » ? Oui, et bien. Un développeur web en tire-t-il de quoi mieux coder demain ? À moitié. C'est un bon livre pour comprendre la machine, et un mauvais livre de conseils.
Sa force : il calcule devant vous. Chaque mécanisme arrive avec un exemple chiffré qu'on peut refaire à la main, du cache de 512 octets aux 10 752 cœurs du GPU. Il compte, multiplication par multiplication, ce qu'un token demande en calcul (idée 6).
Ses faiblesses, avec leur coût pour vous :
- Il est gros et dispersé. Sur dix-neuf sections, quatre blocs sont hors sujet pour un développeur web. Ce sont l'histoire de l'ENIAC (un ordinateur de 1945) et du 6502 (une puce de 1975), Bitcoin, la voiture autonome et l'informatique quantique. Si vous le lisez dans l'ordre, vous passerez des heures loin de votre métier.
- Ses exemples chiffrés détaillés datent de 2019 et 2020. Vous devrez les transposer seul vers les machines d'aujourd'hui (détail dans « Toujours valable en 2026 ? »).
- Il ne dit rien de Spectre ni de Meltdown, deux failles de 2018 (hors livre, à vérifier, sources dans « Toujours valable en 2026 ? »). Elles attaquent le travail lancé à l'avance par le processeur. Vous apprendrez ce mécanisme sans savoir qu'il a été attaqué.
- Ses conseils pratiques se résument en trois : mesurer, éviter les branchements, faire tenir ses données dans les caches. Il vous donne le pourquoi, rarement le quoi faire.
Mon conseil : lisez la section sur les performances (caches et pipeline), celle sur la mémoire virtuelle et celle sur le GPU. Ajoutez les modèles de langage si vous travaillez avec l'IA. Survolez les jeux d'instructions, sautez les quatre blocs hors sujet sans remords. Si vous ne devez lire qu'un livre sur le sujet, prenez d'abord Write Great Code, volume 1, de Randall Hyde. Il est plus tourné vers le code. Gardez Ledin pour le GPU, les modèles de langage et la virtualisation, que Hyde ne couvre pas.
Odilon
Toujours valable en 2026 ?
Les mécanismes restent valables : l'escalier des mémoires, le cache par ensembles, le pipeline, la traduction d'adresses, les anneaux. Les exemples détaillés datent (2019 et 2020). Le livre décrit aussi du matériel de 2024 et 2025, mais sans le calculer, et plusieurs sujets manquent.
- Le GPU détaillé est la RTX 3090, de l'architecture Ampere de NVIDIA (2020). Le livre dit lui-même qu'un GPU haut de gamme de 2025 atteint des centaines de téraflops, quand la 3090 en fait 35,6. Un téraflops vaut mille milliards d'opérations à virgule par seconde. La RTX 5080, plus récente, n'a que quelques paragraphes et aucun calcul de cœurs (leçons 90 et 128).
- Les appels système : le coût chiffré ne porte que sur Windows, avec
int 2ehd'avant XP. Le livre n'en donne aucun pour Linux (leçon 82). - Spectre et Meltdown ne sont pas dans le livre. Ces deux failles exploitent l'exécution sur un chemin parié, dite spéculative. Le livre décrit pourtant ce mécanisme. Il traite une autre faille matérielle, Row hammer, qui change des bits dans des lignes voisines de la DRAM (leçons 77, 128 et 148).
- La cohérence des caches : quand chaque cœur a son cache, ils peuvent garder des copies différentes d'une même case. La cohérence consiste à les garder d'accord. Le livre décrit une méthode, l'espionnage : chaque cœur surveille les écritures des autres. Elle ne passe pas à l'échelle, c'est-à-dire qu'elle ne tient plus à des dizaines de cœurs. Le livre renvoie à d'autres protocoles, sans en nommer (leçon 74).
- ARM : le jeu d'instructions est détaillé, mais l'exemple de matériel est un téléphone, avec la puce Apple A19 Pro. Aucune puce ARM d'ordinateur ou de serveur n'est détaillée. Les cœurs mixtes, les uns rapides et les autres économes, n'apparaissent que dans ce téléphone et le Core Ultra 9. Une seule phrase compare les ARM 64 bits aux serveurs x64, le x86 en 64 bits (leçons 105 à 108, 122, 127 et 128).
- La mémoire virtuelle n'est détaillée qu'en 32 bits, sur deux niveaux. Pour le 64 bits, le livre donne seulement la taille des espaces d'adresses (leçons 102, 108 et 114).
- Les modèles de langage s'appuient sur GPT-2 (2019), un choix pédagogique assumé. Les optimisations récentes n'occupent que quelques lignes, sans calcul. L'attention éparse consiste à n'examiner qu'une sélection de mots. Le mélange d'experts envoie la question à la partie du réseau la mieux placée pour répondre (leçon 135).
- Les deux failles Spectre et Meltdown ont été publiées en janvier 2018. Source : Google Project Zero, projectzero.google/2018/01/reading-privileged-memory-with-side.html.
- Le faux partage, absent du livre, survient quand deux cœurs modifient deux variables situées sur la même ligne de 64 octets. Source : Wikipedia, article « False sharing ».
Pour qui ?
Lisez-le si
- Vous voulez enfin comprendre ce que veulent dire « cache », « pipeline » ou « mémoire virtuelle » quand on parle de performance.
- Vous travaillez avec des modèles de langage et voulez savoir pourquoi ils réclament des GPU.
- Vous aimez refaire un calcul à la main pour être sûr d'avoir compris.
- Vous louez des VM ou des serveurs et voulez savoir ce que l'hyperviseur fait sous votre système.
Passez si
- Vous cherchez des recettes d'optimisation pour PHP ou JavaScript : le livre n'en donne presque pas.
- Vous connaissez déjà l'architecture des processeurs : vous y trouverez une synthèse propre, rien de neuf.
- Vous n'avez pas le temps de trier un gros livre dont une bonne part est hors sujet pour vous.
Ce cours vidéo fait partie d'ExpertEdge, l'abonnement de Packt aux livres et cours vidéo techniques. Le code ODILON50 donne 50 % de remise sur l'abonnement annuel : le cours sur ExpertEdge. Lien affilié : je touche une commission si vous vous abonnez avec ce code, et mes notes n'en dépendent pas.
Pour aller plus loin
- Write Great Code, volume 1 de Randall Hyde : les caches et le pipeline vus depuis le code. À lire en premier.
- Write Great Code, volume 2 : ce que le compilateur fait de votre code.
- Programming Pearls de Jon Bentley : mesurer avant d'optimiser, le conseil de Ledin mis en pratique.
- High Performance Browser Networking et Computer Networks : la même logique d'attente et de temps de réponse, côté réseau.
- Le grand livre du développeur, chapitre 1 : bits, mémoire et cache, en plus court.
- Le dépôt GitHub de Packt pour ce livre (licence MIT) : les exercices du livre.
Fiche fondée sur la version cours d'ExpertEdge : 180 leçons extraites, 89 lues en détail sur 198 annoncées. Les encadrés « Ma lecture » et les mentions « hors livre » viennent de moi, pas du livre.
Source : leçons 3, 62 à 124, 127 à 128, 131 et 133 à 154 lues en détail.
Commentaires (0)