Du 1er au 7 octobre, une même modification de code a été relue quinze fois de suite par une IA. Chaque relecture s'appelle un tour.
Au tour 7, l'IA n'a rien trouvé à redire : la modification ne comptait que neuf lignes changées. Au tour 8, elle en comptait 400, et l'IA est repartie à la chasse aux défauts. Personne n'avait fixé de nombre maximal de tours.
Voilà le piège : « zéro défaut » ne veut pas dire « terminé », parce que le code continue de changer. Si personne n'écrit quand s'arrêter, la relecture continue tant que le code change.
Cette IA de relecture est un skill de Claude Code. Claude est l'IA d'Anthropic, et Claude Code l'assistant de programmation qu'on pilote au clavier. Un skill est un dossier d'instructions que l'assistant charge pour un type de tâche. Le mien s'appelle senior-review.
Depuis, chaque étape de mon travail a une règle d'arrêt qu'on peut vérifier. Je la raconte sur un cas réel, livré le 27 octobre.
Ce cas réel est un ticket : une demande écrite, comme un bug à corriger, qu'on livre en une modification relue. Un second skill, ticket, enchaîne pour moi cinq étapes : plan, code, preuve, revue, bilan.
Chaque étape a un responsable. C'est souvent un agent, une instance de Claude lancée pour une tâche précise. Je décris la méthode, pas le fichier du skill.
Un modèle par étape, parce qu'aucun ne se relit lui-même
Planifier, coder et relire sont trois métiers. Je les confie à trois agents différents. Chacun tourne sur un modèle de la famille Claude : Fable, Sonnet ou Opus.
Une comparaison : l'architecte, le maçon et le contrôleur technique. Le maçon ne signe pas la réception de son propre mur. J'ai expliqué dans un autre article pourquoi le relecteur ne doit jamais être l'auteur.
Le plan liste les étapes, les fichiers à toucher et les tests à écrire d'abord. Je lance tout en une phrase : « plan fable execution sonnet /senior-review opus ». Le skill ticket la lit mot à mot.
| J'écris | Ce que le skill lance |
|---|---|
| « plan fable » | un agent Fable écrit le plan |
| « exécution sonnet » | un agent exécutant, sur Sonnet, écrit le code |
| « /senior-review opus en boucle » | des relecteurs Opus, tour après tour |
Sans précision, le skill applique ce même trio.
Ce choix de modèles est un réglage, pas une mesure. Le schéma montre les cinq étapes et leur responsable.
Le test rougit avant la première ligne de code
Mon vérificateur de contraste dit si un texte reste lisible sur son fond, par exemple du gris sur du blanc. Le contraste mesure l'écart de clarté entre les deux.
Il avait un défaut. Un lien collé dans une revue de maquette, où l'on commente le dessin d'un écran, rouvrait l'outil avec ses couleurs habituelles. Le ticket réel s'intitule « Partager une vérification de contraste par lien ».
Les deux couleurs s'écrivent à la fin de l'URL, l'adresse de la page : ?fg=767676&bg=ffffff. Pour ce gris sur blanc, l'outil doit afficher le ratio de contraste, le nombre qu'il calcule : 4.54.
Le ticket ajoute deux exigences. Changer une couleur met l'URL à jour sans recharger la page, avec history.replaceState. Une valeur invalide comme ?fg=zzz ramène les couleurs habituelles, sans erreur.
Un test est un petit programme qui vérifie que le code fait ce qu'on attend. Le TDD consiste à écrire ce test avant le code. Il échoue d'abord (rouge), puis il passe (vert) quand le code arrive.
Mon test est e2e, de bout en bout : un vrai navigateur ouvre la vraie page, comme un utilisateur. Il utilise Playwright, un outil qui pilote un navigateur par code.
Résultat réel du premier lancement, avant le code (extrait) :
✘  5 […] › 1. ?fg=767676&bg=ffffff : couleurs du lien appliquées, AA normal réussi (8.9s)
    Expected: "767676"
    Received: "1A1A2E"
  5 failed
  2 passed (10.9s)
Le message nomme le défaut : le champ affiche 1A1A2E, la couleur habituelle, au lieu de 767676. Le test échoue pour la bonne raison. Il calcule lui-même le ratio attendu avec la formule officielle (WCAG).
Deux tests passaient déjà. L'un vérifie mon propre calcul du ratio. L'autre est le cas ?fg=zzz, qui marchait même sans la fonctionnalité. Il protège d'une future casse, mais ne prouve rien sur la lecture de l'URL.
Un agent Sonnet écrit ensuite le code. Il part d'un brief, des consignes écrites qui n'héritent de rien de ma session : le plan, les fichiers autorisés, les interdits.
Annule le correctif : si le test reste vert, il ne prouvait rien
Un test vert ne prouve rien tant qu'on ne l'a pas vu échouer sans le correctif. La mutation inverse consiste à défaire le correctif. Le test doit alors repasser au rouge.
S'il reste vert, il ne vérifiait pas ce que tu croyais. Le mutation testing automatise ce geste sur tout un projet : voir mon article sur le mutation testing.
Avant la revue, sur le premier jet du code, j'ai défait le correctif de quatre façons. J'ai retiré la lecture de l'URL, puis son écriture. J'ai remplacé replaceState par pushState, son cousin qui ajoute une page à l'historique. J'ai retiré la vérification des valeurs.
Chaque essai a fait échouer au moins un test. D'autres ont suivi pendant la revue, et l'un n'a rien fait rougir : c'est l'histoire du tour 2. Résultats réels de deux essais :
=== M1 : lecture de l'URL retirée
  4 failed
  3 passed (10.7s)
=== M2 : replaceState retiré
  1 failed
  6 passed (2.2s)
Ensuite je regarde la page comme un utilisateur, avec des captures à trois tailles : mobile (390×844), tablette (820×1180) et desktop (1280×900).
Mon rapport de preuves sépare trois choses, une ligne chacune :
- le code est juste : les tests vus rouges puis verts, et la mutation inverse ;
- l'effet est visible : une capture lue comme l'utilisateur la verrait ;
- ce qui reste non vérifié : ce que le test a vraiment parcouru, et ce qu'il n'a pas touché.
Sur ce ticket, deux zones n'ont aucun test. Aucun test ne clique les boutons « Appliquer ». Les liens de changement de langue perdent les couleurs du lien.
Avant de croire l'agent, je relance moi-même les contrôles automatiques du projet, puis je lis chaque capture. Ci-dessous, le même lien aux trois tailles, pris sur le vrai site en ligne.
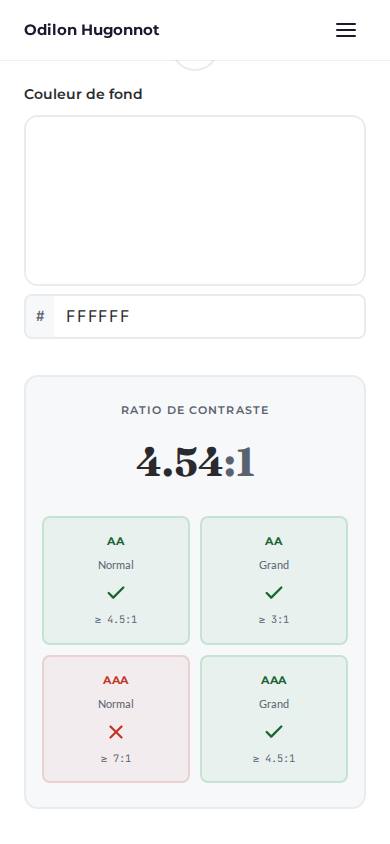
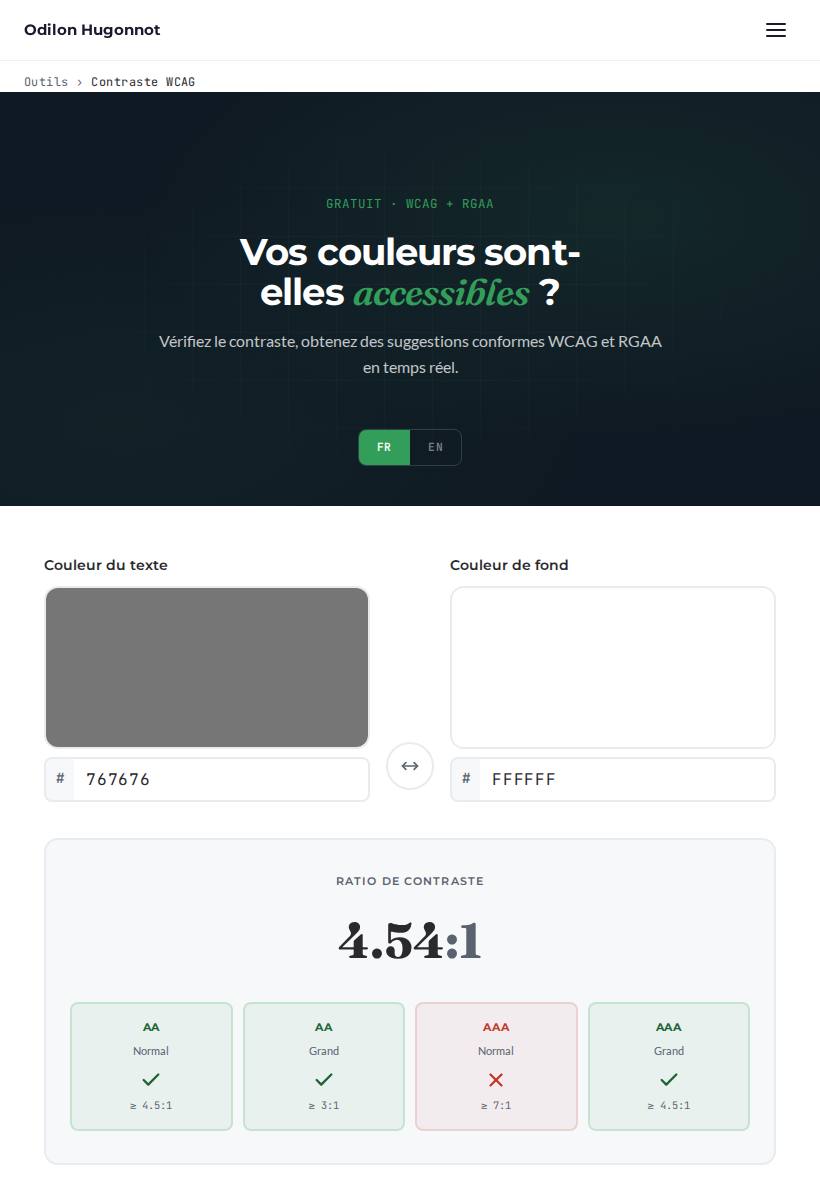
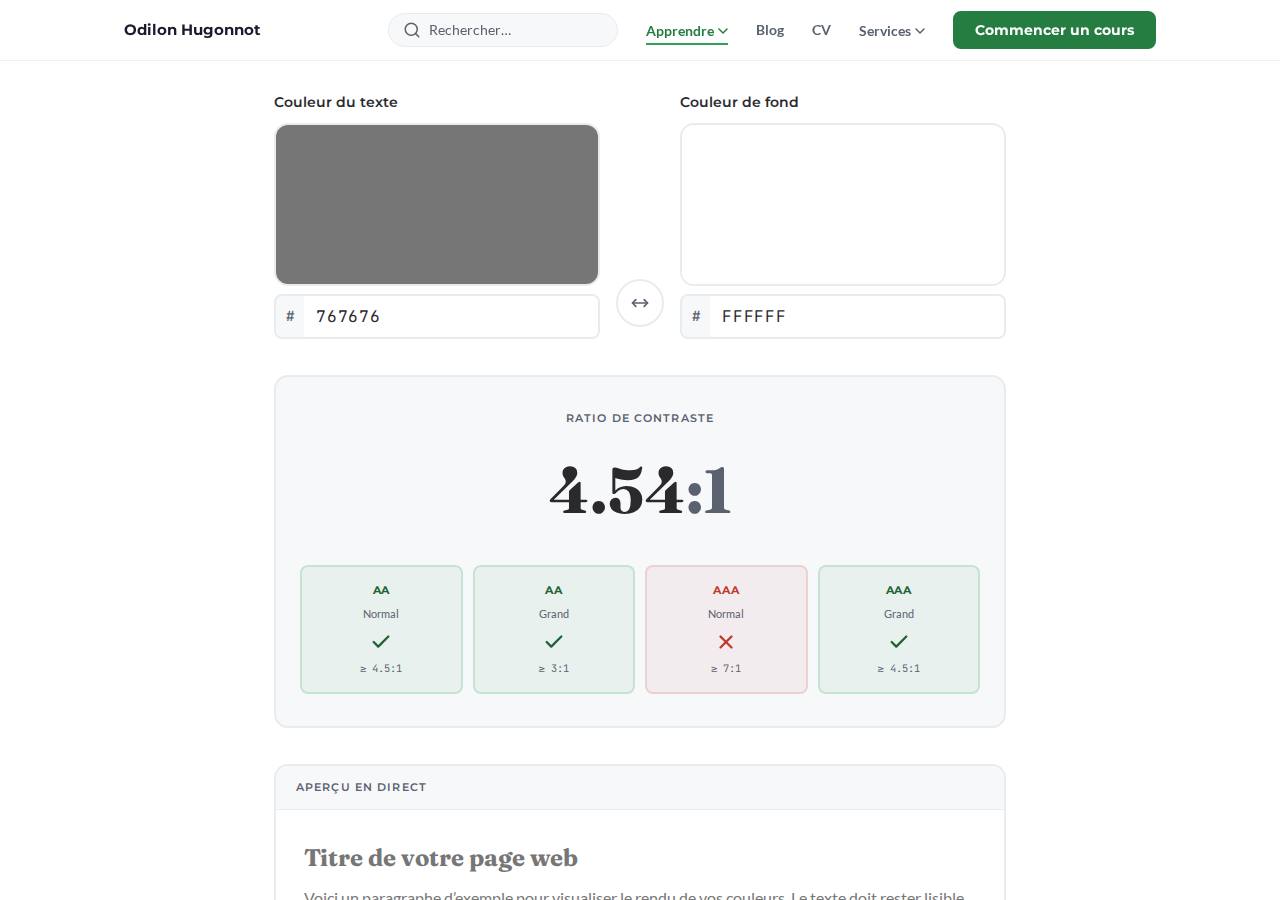
Les trois captures affichent 4.54, sans défilement horizontal. La méthode pour attraper les bugs d'affichage avec Playwright est dans mon article sur le test responsive.
La revue tourne jusqu'au tour qui ne change rien
Sur ce ticket, deux relecteurs ont travaillé en parallèle aux tours 1 et 2, un sur le code et un sur les tests. Il n'en est resté qu'un au tour 3. Tous étaient sur Opus, soit cinq relecteurs en tout.
Ils sont « aveugles » : ils ne savent pas qui a écrit le code ni ce que l'auteur en pense.
Un relecteur signale des défauts. Chaque défaut signalé s'appelle un finding, bloquant s'il empêche d'intégrer le code au projet, important s'il doit être corrigé avant la suite.
Les tours forment une boucle : on relit, on corrige, on relit. Elle s'arrête quand un tour remplit trois conditions :
- aucun finding bloquant ;
- aucun finding important encore ouvert ;
- aucune modification de code.
Un changement qui ne touche que des tests compte comme une modification : on refait un tour. Au cinquième tour sans conclusion, la boucle s'arrête et me rend la main.
Mes relecteurs devaient seulement lire, je l'avais écrit dans leur consigne. En réalité ils avaient tous les droits, Edit et Write compris : ils pouvaient modifier les fichiers. Une consigne n'est qu'une demande. Seule la définition de l'agent interdit vraiment une action.
Tour 1 : un vrai bug, trois trous de tests
Dans l'outil, on choisit une couleur avec un sélecteur. Quand on le déplace, il signale un évènement à chaque petit mouvement. Mon code réécrivait l'URL à chaque évènement.
Or WebKit, le moteur de Safari, accepte au plus 100 réécritures en 10 secondes. Au-delà, il renvoie une erreur, SecurityError. L'URL reste alors figée sur une vieille couleur, alors que le ratio affiché est juste.
Playwright sait lancer ce moteur, et un relecteur a reproduit le bug avec lui. Chromium, le moteur de Chrome, finit sur la bonne URL. Le correctif : écrire l'URL 250 ms après le dernier évènement, pas à chacun.
Le relecteur a aussi trouvé trois trous dans mes tests :
- l'échange des couleurs et la saisie du fond n'étaient pas vérifiés dans l'URL ;
- la version anglaise de l'outil n'était pas vérifiée après la réécriture de l'URL ;
- la lecture de la couleur de fond n'avait aucun contrôle explicite.
Tour 2 : mon test ne surveillait pas le délai
J'ai remplacé 250 ms par 0 dans le code. Les neuf tests sont restés verts, donc aucun ne surveillait vraiment le délai. La raison : mon test envoyait les 150 évènements d'un coup, trop vite pour que le délai change quoi que ce soit.
Le test espace maintenant ses évènements de 16 ms, le rythme d'un glisser. Résultats réels, extraits :
# M-a : debounce retiré (setTimeout 250 -> 0)
  9 passed (10.3s)
# Tour 2, M-c : setTimeout 0 avec rafale espacée de 16 ms
  1 failed   8 passed
# Tour 2, code restauré
  9 passed (5.2s)
Deux remarques en plus. Quitter la page avant 250 ms perd la dernière couleur de l'URL : rejeté, aucun humain ne copie une URL en 250 ms. Le ticket annonçait « 4,54:1 », l'outil affiche « 4.54 » : critère mal formulé, pas bug.
Tour 3 : rien à signaler
Un dernier relecteur n'a rien levé. Le test du délai a réussi 90 fois sur 90, même sous charge, avec 4 boucles CPU à 100 %. Le code n'a pas changé : la boucle s'arrête.
Total : 9 findings. 5 corrigés, 1 rejeté, 3 reportés, c'est-à-dire remis à plus tard. Ces 3 ne font que deux sujets. Le premier est la réécriture de l'URL sans paramètres au chargement : vue par deux tours, donc comptée deux fois. Le second est l'écart de formulation du ticket, qui n'est pas un défaut du code.
Mon journal disait que tout allait bien
Mon skill de revue tient un journal : une ligne par revue, avec les findings signalés, confirmés et écartés. Au 27 octobre, il affichait 981 findings confirmés. Mais « confirmé » voulait seulement dire « a passé mon filtre ». Le journal ne disait pas si j'avais ensuite corrigé le défaut ou refusé de le corriger. Je raconte cette découverte, chiffres et coût par finding compris, dans mon article sur la revue de code par IA.
Le journal note maintenant le sort de chaque finding confirmé : corrigé, rejeté ou reporté. Ce ticket est la première revue qui le porte : 5 corrigés, 1 rejeté et 3 classés « reportés ». C'est un seul vrai report vu deux fois, plus l'écart de formulation du ticket.
Je n'annonce donc aucun taux d'acceptation : sur une seule revue, il ne voudrait rien dire. Je ne peux pas non plus dire que Fable planifie mieux, ni qu'Opus relit mieux que Sonnet. C'est mon réglage, pas un résultat.
Dernière étape, le bilan. Je relis mes corrections de la session (« tu as testé ? », « tu es sûr ? ») : chacune révèle une règle qui manquait. Le skill m'en propose trois au plus, avec leur destination. Rien n'est écrit sans mon accord. Ce ticket en a donné une : un test qui prouve un délai espace ses évènements.
Conclusion
Chaque règle de cette chaîne est née d'un échec constaté du dehors. Une boucle qui a tourné quinze fois. Des relecteurs « en lecture seule » qui pouvaient écrire. Un journal qui se notait avec son propre filtre.
Je n'ai aucune mesure avant et après : je ne te promets ni gain de temps ni gain de qualité. Je te propose deux gestes pour demain. Écris la condition d'arrêt de ta boucle avant de la lancer. Défais ton correctif avant de croire ton test.